


C语言进阶 23:宏、条件编译与预处理陷阱
- 1C语言初阶 01:初识 C 语言与第一个程序
- 2C语言初阶 02:数据类型、变量、常量与字符
- 3C语言初阶 03:常见操作符与表达式求值
- 4C语言初阶 04:分支、循环与流程控制
- 5C语言初阶 05:用猜数字游戏串起分支与循环
- 6C语言初阶 06:一维数组、二维数组与字符串
- 7C语言初阶 07:函数设计、传参与多文件程序
- 8C语言初阶 08:从零组织命令行扫雷项目
- 9C语言初阶 09:用调试器定位错误与观察内存
- 10C语言初阶 10:函数递归、调用展开与递归的代价
- 11C语言初阶 11:地址、指针类型与指针运算
- 12C语言初阶 12:用结构体描述复杂对象
- 13C语言进阶 13:进制、补码、字节序与位运算
- 14C语言进阶 14:数组名、数组指针与二维数组传参
- 15C语言进阶 15:动态内存、realloc 与柔性数组
- 16C语言进阶 16:函数指针、回调与通用排序
- 17C语言进阶 17:指针的边界、const、断言与所有权
- 18C语言进阶 18:字符与字符串函数的完整使用规则
- 19C语言进阶 19:memcpy、memmove、memset 与 memcmp
- 20C语言进阶 20:结构体嵌套、自引用、对齐与位域
- 21C语言进阶 21:联合体、枚举与带标签的数据模型
- 22C语言进阶 22:从源代码到可执行文件的编译链接过程
- 23C语言进阶 23:宏、条件编译与预处理陷阱本文
- 24C语言进阶 24:文件读写、错误处理与数据持久化
代码块包含可运行实现、局部片段、输出、故意出错的示例与思考题;它们是独立示例,请结合上下文阅读,不能将整章拼成一个程序。
阅读前先核对
- 宏括号只解决优先级,不解决参数重复求值;
SQUARE(i++)这类表达式可能触发未定义行为。现代编译器可内联函数,不能断言宏永远更快。 - 用户宏避免保留名称;ifdef 只判断是否定义,定义为 0 仍会进入。字符串化/拼接有参数展开例外,需两层宏时按原理处理。
本章目标
-
深刻理解编译器在预处理阶段的工作
-
掌握#define定义常量和宏
-
掌握宏在编写时的各种细节,以及宏和函数的对比
-
掌握条件编译和代码编写
-
掌握条件编译在头文件包含中的作用
-
了解#和##的作用,能够阅读和理解这类代码
1. 预定义符号
C语言设置了一些预定义符号,可以直接使用,预定义符号也是在预处理期间处理的。
课件代码 23-001 · PDF 第 1 页
__FILE__ //进行编译的源文件__LINE__ //文件当前的行号__DATE__ //文件被编译的日期__TIME__ //文件被编译的时间__STDC__ //如果编译器遵循ANSI C,其值为1,否则未定义举个例子:
课件代码 23-002 · PDF 第 1 页
printf("file:%s line:%d\n", __FILE__, __LINE__);2. #define 定义常量
基本语法:
课件代码 23-003 · PDF 第 2 页
#define name stuff举个例子:
课件代码 23-004 · PDF 第 2 页
#define MAX 1000#define reg register //为 register这个关键字,创建一个简短的名字#define do_forever for(;;) //用更形象的符号来替换一种实现#define CASE break;case //在写case语句的时候自动把 break写上。
// 如果定义的 stuff过长,可以分成几行写,除了最后一行外,每行的后面都加一个反斜杠(续行 符)。#define DEBUG_PRINT printf("file:%s\tline:%d\t \ date:%s\ttime:%s\n" ,\ __FILE__,__LINE__ , \ __DATE__,__TIME__ )思考:在define定义标识符的时候,要不要在最后加上 ; ?比如:
课件代码 23-005 · PDF 第 2 页
#define MAX 1000;#define MAX 1000建议不要加上 ; ,这样容易导致问题。
比如下面的场景:
课件代码 23-006 · PDF 第 2 页
if(condition) max = MAX;else max = 0;如果是加了分号的情况,等替换后,if和else之间就是2条语句,而没有大括号的时候,if后边只能有一条语句。这里会出现语法错误。
3. #define定义宏
#define 机制包括了一个规定,允许把参数替换到文本中,这种实现通常称为宏。
下面是宏声明的语法形式:
课件代码 23-007 · PDF 第 3 页
#define name( parament-list ) stuff其中的 parament-list 是一个由逗号隔开的符号表,它们可能出现在stuff中。参数列表的左括号必须与 name 紧邻,如果两者之间有任何空白存在,参数列表就会被解释为 stuff 的一部分。
举例:
课件代码 23-008 · PDF 第 3 页
#define SQUARE( x ) x * x
SQUARE(5);SQUARE宏接收一个参数 x ,如果在上述声明之后,对 SQUARE(5); 这句代码,经过预处理器处理后,替换成表达式: 5 * 5 。
3.1 宏定义中括号的使用
前面写的 SQUARE 宏是不是完全正确呢?我们再看一个案例
课件代码 23-009 · PDF 第 3 页
#include <stdio.h>
int main(){ int a = 5; printf("%d\n" , SQUARE( a + 1 ); return 0;}原例说明: 课件 printf 示例缺一个右括号;正确形式为
printf("%d\n", SQUARE(a + 1));,宏本身仍需按后文讨论补括号。
乍一看,你可能觉得这段代码将打印36,因为a+1得到6,6的平方就是36了。
但是事实上它将打印11,为什么呢?
原因就是:宏的参数是原样替换到宏体内的文本中的,参数 x 被替换成 a + 1 ,这样宏体中的 x 会被替换成 a+1所以这条语句替换完后,实际上变成了:
课件代码 23-010 · PDF 第 4 页
printf ("%d\n", a + 1 * a + 1 );这样就比较清晰了,由替换产生的表达式并没有按照预想的次序进行求值。
📌 宏参数中的操作符和宏体中的操作符的优先级,导致计算顺序和预期不相符。
解决办法:在宏定义中给宏体内的参数文本加上括号,这样保证替换到宏体中的每个参数都是独立的表达式。
课件代码 23-011 · PDF 第 4 页
#define SQUARE(x) (x) * (x)这样预处理之后就产生了预期的效果:
课件代码 23-012 · PDF 第 4 页
printf ("%d\n",(a + 1) * (a + 1) );这里还有一个宏定义:
课件代码 23-013 · PDF 第 4 页
#define DOUBLE(x) (x) + (x)定义中我们使用了括号,想避免之前的问题,但是这个宏可能会出现新的错误。
课件代码 23-014 · PDF 第 4 页
int a = 5;printf("%d\n" ,10 * DOUBLE(a));这将打印什么值呢?看上去,好像打印100,但事实上打印的是55.我们发现替换之后:
课件代码 23-015 · PDF 第 4 页
printf ("%d\n",10 * (5) + (5));乘法运算先于宏定义的加法,所以出现了 55 .这个问题,的解决办法是在宏定义表达式两边加上一对括号就可以了。
课件代码 23-016 · PDF 第 5 页
#define DOUBLE(x) ( ( x ) + ( x ) )📌 结论:
用于对数值表达式进行求值的宏定义都应该用上述方式加上括号,避免在使用宏时由于参数中的操作符和邻近操作符之间不可预料的相互作用。
3.2 带有副作用的宏参数
当宏参数在宏的定义中出现超过一次的时候,如果参数带有副作用,那么你在使用这个宏的时候就可能出现危险,导致不可预测的后果。副作用就是表达式求值的时候出现的永久性效果。
副作用举例:
课件代码 23-017 · PDF 第 5 页
x+1;//不带副作用x++;//带有副作用请看下面的代码, MAX 宏可以证明具有副作用的参数所引起的问题
课件代码 23-018 · PDF 第 5 页
#include <stdio.h>
#define MAX(a, b) ( (a) > (b) ? (a) : (b) )
int main(){ x = 5; y = 8; z = MAX(x++, y++); printf("x=%d y=%d z=%d\n", x, y, z);//输出的结果是什么?
return 0;}原例说明: 课件 x、y、z 未先声明,运行示范前补
int x, y, z;;这里重点是宏参数重复求值。
这里我们得知道预处理器处理之后的结果是什么:
课件代码 23-019 · PDF 第 6 页
z = ( (x++) > (y++) ? (x++) : (y++));所以输出的结果是:x=6 y=10 z=9
3.3 宏替换的规则
在程序中扩展 #define 定义符号和宏时,需要涉及几个步骤。
- 在调用宏时,首先对参数进行检查,看看是否包含任何由 #define 定义的符号。如果是,它们首
先被替换。
-
替换文本随后被插入到程序中原来文本的位置。对于宏,参数名被他们的值所替换。
-
最后,再次对结果文件进行扫描,看看它是否包含任何由 #define 定义的符号。如果是,就重复
上述处理过程。
注意:
-
宏参数和 #define 定义中可以出现其他 #define 定义的符号。但是对于宏,不能出现递归。
-
当预处理器搜索 #define 定义的符号的时候,字符串常量的内容并不被搜索。
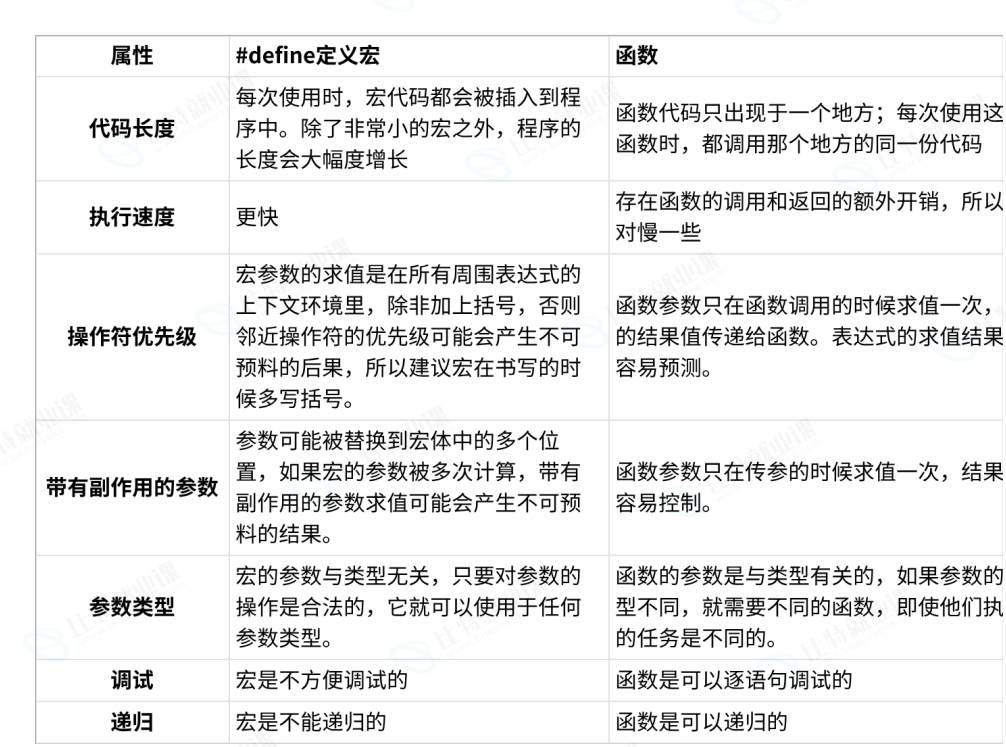
3.4 宏和函数的对比
我们学到这里发现宏和函数,是有很多相似性的,那什么情况使用宏?什么情况使用函数呢?
📌 宏通常被应用于执行简单的运算
比如在两个数中找出较大的一个时,写成下面的宏,更有优势一些。
课件代码 23-020 · PDF 第 6 页
#define MAX(a, b) ((a)>(b)?(a):(b))那为什么不用函数来完成这个任务?
原因有二:
- 用于调用函数和从函数返回的代码可能比实际执行这个小型计算工作所需要的时间更多。所以宏比
函数在程序的规模和速度方面更胜一筹。
- 更为重要的是函数的参数必须声明为特定的类型。所以函数只能在类型合适的表达式上使用。反之
这个宏怎可以适用于整形、长整型、浮点型等可以用于 > 来比较的类型。宏的参数是类型无关的。
和函数相比宏的劣势:
- 每次使用宏的时候,一份宏定义的代码将插入到程序中,除非宏比较短,否则可能大幅度增加程序
的长度。
- 宏是没法调试的,程序到调试的时候,宏已经被替换了,所以程序执行的代码和程序员看到的代码
是不一致。
-
宏由于类型无关,也就不够严谨。
-
宏可能会带来运算符优先级的问题,导致程容易出现错。
宏有时候可以做函数做不到的事情。比如:宏的参数可以出现类型,但是函数做不到。
课件代码 23-021 · PDF 第 7 页
#define MALLOC(num, type)\ (type )malloc(num sizeof(type)) ... //使用 MALLOC(10, int);//类型作为参数
//预处理器替换之后: (int *)malloc(10*sizeof(int));宏和函数的一个对比
4. 命名约定
一般来讲函数和宏的使用语法很相似。所以语言本身没法帮我们区分二者。
那我们平时的一个习惯是:
-
把宏名全部大写
-
函数名不要全部大写
5. #undef
这条指令用于移除一个宏定义,如果现存的一个名字需要被重新定义或者,那么可以先移除旧名字。
语法形式如下:
课件代码 23-022 · PDF 第 8 页
#undef NAME6. 条件编译
你在开发时希望在屏幕上打印一些调试信息,但正式发布时这些信息必须全部消失。你会怎么做?
手动删除 printf ?那下次调试又得加回来,太蠢了。
条件编译就是用来解决这类“根据条件保留或丢弃代码”的问题的。它在编译前由预处理器处理,符合条件的代码才会被编译器看到。
C语言中就是使用条件编译指令来完成,将将一条语句(一组语句)编译或者放弃是很方便的。
下面代码中的橙色部分就是条件编译的代码,决定了第12行代码是否保留。
课件代码 23-023 · PDF 第 9 页
#include <stdio.h>#define __DEBUG__
int main(){ int i = 0; int arr[10] = {0}; for(i = 0; i < 10; i++) { arr[i] = i + 1; #ifdef __DEBUG__ printf("%d\n", arr[i]);//为了观察数组是否赋值成功。 #endif //__DEBUG__ } return 0;}下面是常见的条件编译指令:
课件代码 23-024 · PDF 第 9,10 页
1.#if 常量表达式 //...#endif//常量表达式由预处理器求值。如:#define __DEBUG__ 1#if __DEBUG__ //..#endif2.多个分支的条件编译#if 常量表达式 //...#elif 常量表达式 //...#else //...#endif
3.判断是否被定义#if defined(symbol)#ifdef symbol
#if !defined(symbol)#ifndef symbol
4.嵌套指令#if defined(OS_UNIX) #ifdef OPTION1 unix_version_option1(); #endif #ifdef OPTION2 unix_version_option2(); #endif#elif defined(OS_MSDOS) #ifdef OPTION2 msdos_version_option2(); #endif#endif条件编译的三大典型场景:头文件保护、调试开关、跨平台的代码适配。
📌 AI提示词1:编写样例代码,展示一下C语言中条件编译,在调试开关方面的使用。
AI提示词2:编写样例代码,展示一下C语言中条件编译,在跨平台的代码适配方面的使用。
7. 头文件的包含
到目前为止,我们见过了两种头文件包含的方式, #include <xxx.h> 和 #include”xxx.h” ,它们有什么区别吗?接下来我们看看。
7.1 头文件被包含的方式
7.1.1 本地文件包含
课件代码 23-025 · PDF 第 11 页
#include "xxx.h"查找策略:
先在源文件所在目录下查找,如果该头文件未找到,编译器就像查找库函数头文件一样在标准位置查找头文件。
如果找不到就提示编译错误。
Linux环境的标准头文件的路径:
课件代码 23-026 · PDF 第 11 页
/usr/includeVS环境的标准头文件的路径:
课件代码 23-027 · PDF 第 11 页
C:\Program Files (x86)\Microsoft Visual Studio 12.0\VC\include//这是VS2013的默认路径注意按照自己的安装路径去找。
7.1.2 库文件包含
课件代码 23-028 · PDF 第 11 页
#include <xxx.h>查找头文件直接去标准路径下去查找,如果找不到就提示编译错误。
这样是不是可以说,对于库文件也可以使用 “” 的形式包含?
答案是肯定的,可以,但是这样做查找的效率就低些,当然这样也不容易区分是库文件还是本地文件了。
7.2 嵌套文件包含
我们已经知道, #include 指令可以使另外一个文件被编译。就像它实际出现于 #include 指令的地方一样。
这种替换的方式很简单:预处理器先删除这条指令,并用包含文件的内容替换。
一个头文件被包含10次,那就实际被编译10次,如果重复包含,对编译的压力就比较大。
test.c test.h代码块 代码块
课件代码 23-029 · PDF 第 12 页
#include "test.h"#include "test.h"#include "test.h"#include "test.h"#include "test.h"
int main(){
return 0;}原例说明: 引用 test.h 的示例应建立同节对应头文件;重复包含的效果要结合保护宏观察。
课件代码 23-030 · PDF 第 12 页
void test();struct Stu{ int id; char name[20];};如果直接这样写,test.c文件中将test.h包含5次,那么test.h文件的内容将会被拷贝5份在test.c中。
如果test.h 文件比较大,这样预处理后代码量会剧增。如果工程比较大,有公共使用的头文件,被大家都能使用,又不做任何的处理,那么后果真的不堪设想。
如何解决头文件被重复引入的问题?答案:条件编译。
每个头文件的开头写:
课件代码 23-031 · PDF 第 12 页
#ifndef __TEST_H__#define __TEST_H__//头文件的内容#endif //__TEST_H__或者
课件代码 23-032 · PDF 第 12 页
#pragma once就可以避免头文件的重复引入。
注:
推荐《高质量C/C++编程指南》中附录的考试试卷(很重要)。
笔试题:
-
头文件中的 ifndef/define/endif是干什么用的?
-
#include <filename.h> 和 #include “filename.h” 有什么区别?
8. 其他预处理指令
课件代码 23-033 · PDF 第 13 页
#error#pragma#line...不做介绍,自己去了解。
#pragma pack()在结构体部分介绍。参考《C语言深度解剖》学习,可以借助于AI学习一下,其实都很简单。
📌 AI提示词:介绍一下#pragma在C语言中的使用,并给出代码演示
其他的类似~
9. 命令行定义【加餐】
许多 C 的编译器提供了一种能力,允许在程序编译的命令行中定义符号。用于在编译的过程中指定程序中一些符号的值,方便我们在不修改代码的基础上,编译出不同版本的程序。
例如:当我们根据同一个源文件要编译出一个程序的不同版本的时候,这个特性有点用处。(假定某个程序中声明了一个某个长度的数组,如果机器内存有限,我们需要一个很小的数组,但是另外一个机器内存大些,我们需要一个数组能够大些。)test.c
课件代码 23-034 · PDF 第 13,14 页
#include <stdio.h>
int main(){ int array[SZ]; int i = 0; for(i = 0; i < SZ; i ++) { array[i] = i; } for(i = 0; i < SZ; i ++) { printf("%d " ,array[i]); } printf("\n" ); return 0;}原例说明: SZ 由命令行定义;使用本节 gcc -DSZ=10 等命令,而不是直接单文件默认编译。
编译指令:
课件代码 23-035 · PDF 第 14 页
//linux 环境演示gcc -DSZ=10 test.c10. #和##【加餐】
10.1 #运算符
运算符将宏的一个参数转换为字符串字面量, # 运算符所执行的操作可以理解为”字符串化“。
它仅允许出现在带参数的宏的替换列表中。
当我们有一个变量 int a = 10; 的时候,我们想打印出: the value of a is 10 .就可以写:
课件代码 23-036 · PDF 第 14 页
#define PRINT(n, format) printf("the value of " #n " is "format"\n", n);当我们按照下面的方式调用的时候:
课件代码 23-037 · PDF 第 14 页
PRINT(a, "%d"); //当我们把a替换到宏的体内时,就出现了#a,而#a就是转换为"a",是一个字符 串代码就会被预处理为:
课件代码 23-038 · PDF 第 15 页
printf("the value of " "a" " is ""%d""\n", a);运行代码就能在屏幕上打印:
课件代码 23-039 · PDF 第 15 页
the value of a is 1010.2 ## 运算符
可以把位于它两边的符号合成一个符号,它允许宏定义从分离的文本片段创建标识符。 ## 被称为记号粘合这样的连接必须产生一个合法的标识符。否则其结果就是未定义的。
这里我们想想,写一个函数求2个数的较大值的时候,不同的数据类型就得写不同的函数。
比如:
课件代码 23-040 · PDF 第 15 页
int int_max(int x, int y){ return x > y ? x : y;}
float float_max(float x, float y){ return x > y ? x : y;}但是这样写起来太繁琐了,现在我们这样写代码试试:
课件代码 23-041 · PDF 第 15 页
//宏定义#define GENERIC_MAX(type) \type type##_max(type x, type y)\{ \ return (x>y?x:y); \}使用宏,定义不同函数
课件代码 23-042 · PDF 第 16 页
GENERIC_MAX(int) //替换到宏体内后int##_max 生成了新的符号 int_max做函数名GENERIC_MAX(float) //替换到宏体内后float##_max 生成了新的符号 float_max做函数名
int main(){ //调用函数 int m = int_max(2, 3); printf("%d\n", m); float fm = float_max(3.5f, 4.5f); printf("%f\n", fm);
return 0;}输出:
课件代码 23-043 · PDF 第 16 页
34.500000在实际开发过程中 ## 使用的很少,很难取出非常贴切的例子。
11. Vibe coding 代码实战
实现一个支持多语言、多版本的计算器,主要是体会条件编译的使用场景。
课件代码 23-044 · PDF 第 16 页
提示词:1. 使用C语言实现一个多版本、支持双语言的控制台程序的计算器.2. 普通版本的计算器支持整数的加法和减法,Pro版本的计算器新增支持整数的乘法和除法,除法需要 检测除数是否为03. 计算器支持中文和英文,默认是中文提示信息4. 可以使用条件编译5. 可以加上简易的调试信息和日志的输出支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!