


C语言进阶 20:结构体嵌套、自引用、对齐与位域
- 1C语言初阶 01:初识 C 语言与第一个程序
- 2C语言初阶 02:数据类型、变量、常量与字符
- 3C语言初阶 03:常见操作符与表达式求值
- 4C语言初阶 04:分支、循环与流程控制
- 5C语言初阶 05:用猜数字游戏串起分支与循环
- 6C语言初阶 06:一维数组、二维数组与字符串
- 7C语言初阶 07:函数设计、传参与多文件程序
- 8C语言初阶 08:从零组织命令行扫雷项目
- 9C语言初阶 09:用调试器定位错误与观察内存
- 10C语言初阶 10:函数递归、调用展开与递归的代价
- 11C语言初阶 11:地址、指针类型与指针运算
- 12C语言初阶 12:用结构体描述复杂对象
- 13C语言进阶 13:进制、补码、字节序与位运算
- 14C语言进阶 14:数组名、数组指针与二维数组传参
- 15C语言进阶 15:动态内存、realloc 与柔性数组
- 16C语言进阶 16:函数指针、回调与通用排序
- 17C语言进阶 17:指针的边界、const、断言与所有权
- 18C语言进阶 18:字符与字符串函数的完整使用规则
- 19C语言进阶 19:memcpy、memmove、memset 与 memcmp
- 20C语言进阶 20:结构体嵌套、自引用、对齐与位域本文
- 21C语言进阶 21:联合体、枚举与带标签的数据模型
- 22C语言进阶 22:从源代码到可执行文件的编译链接过程
- 23C语言进阶 23:宏、条件编译与预处理陷阱
- 24C语言进阶 24:文件读写、错误处理与数据持久化
代码块包含可运行实现、局部片段、输出、故意出错的示例与思考题;它们是独立示例,请结合上下文阅读,不能将整章拼成一个程序。
阅读前先核对
- 对齐要求不普遍等于成员 sizeof,课件的默认 pack 规则应结合实际编译器/ABI。用
_Alignof、offsetof、sizeof 验证,不把一次平台结果当语言保证。 - 两次独立匿名结构体定义是不同类型,但匿名类型可通过 typedef 命名复用。位域布局依赖实现,不能取地址或直接 sizeof 位域;协议格式应显式编码。
本章目标
-
掌握结构类型的进阶使用,比如:结构体嵌套、自引用、匿名结构类型
-
掌握结构体数组和成员访问
-
掌握结构体内存对齐的相关知识
-
了解结构体中的位段成员,最起码能够阅读代码,在需要时有深入学习的能力
-
学习使用AI来进行项目的需求确认,规范细化和代码编写
-
掌握复杂代码的阅读能力,遇到问题,借助AI辅助学习的能力
1. 结构体类型声明
1.1 嵌套结构体类型
在《初识结构体》章节,我们就学习了结构体类型的声明,今天我们再探讨一下嵌套结构体类型,也就是在结构体类型中包含了其他的结构体类型。
比如:我们想描述一个学生,学生信息包含:
-
名字
-
生日:年、月、日
-
性别
-
学号
那我们可以设计一个描述学生信息的结构体类型,在结构体中包含的生日信息,也包含年、月、日三个部分,能不能把生日也设计成一个描述日期的结构体类型呢,其实是可以的。
所以就有了下面的代码:
课件代码 20-001 · PDF 第 1,2 页
//描述日期struct Date{ int year; int month; int day;};
//描述学生信息struct Student{ char name[20]; struct Date birthday; char id[20];};
int main(){ //嵌套结构体的初始化 struct Student s = {"aoyun", {2008, 8, 8}, "2026010102"};
//成员的访问 printf("生日:%d-%d-%d\n", s.birthday.year, s.birthday.month, s.birthday.day);
return 0;}1.2 结构体的自引用
结构体在数据结构的学习中非常重要,其中有一种结构体的设计就是:结构体的自引用。
结构体的自引用,是要求在结构体中能够找到和自己同类型的另外一个结构体变量。
举例:
在数据结构中有线性的数据结构,顺序表和链表都属于线性数据结构。这里简单的介绍一下。
假设我们想在程序中存储数据:1 2 3 4 5,存储起来后,后期还需要使用这些数据,那怎么组织这些数据呢?
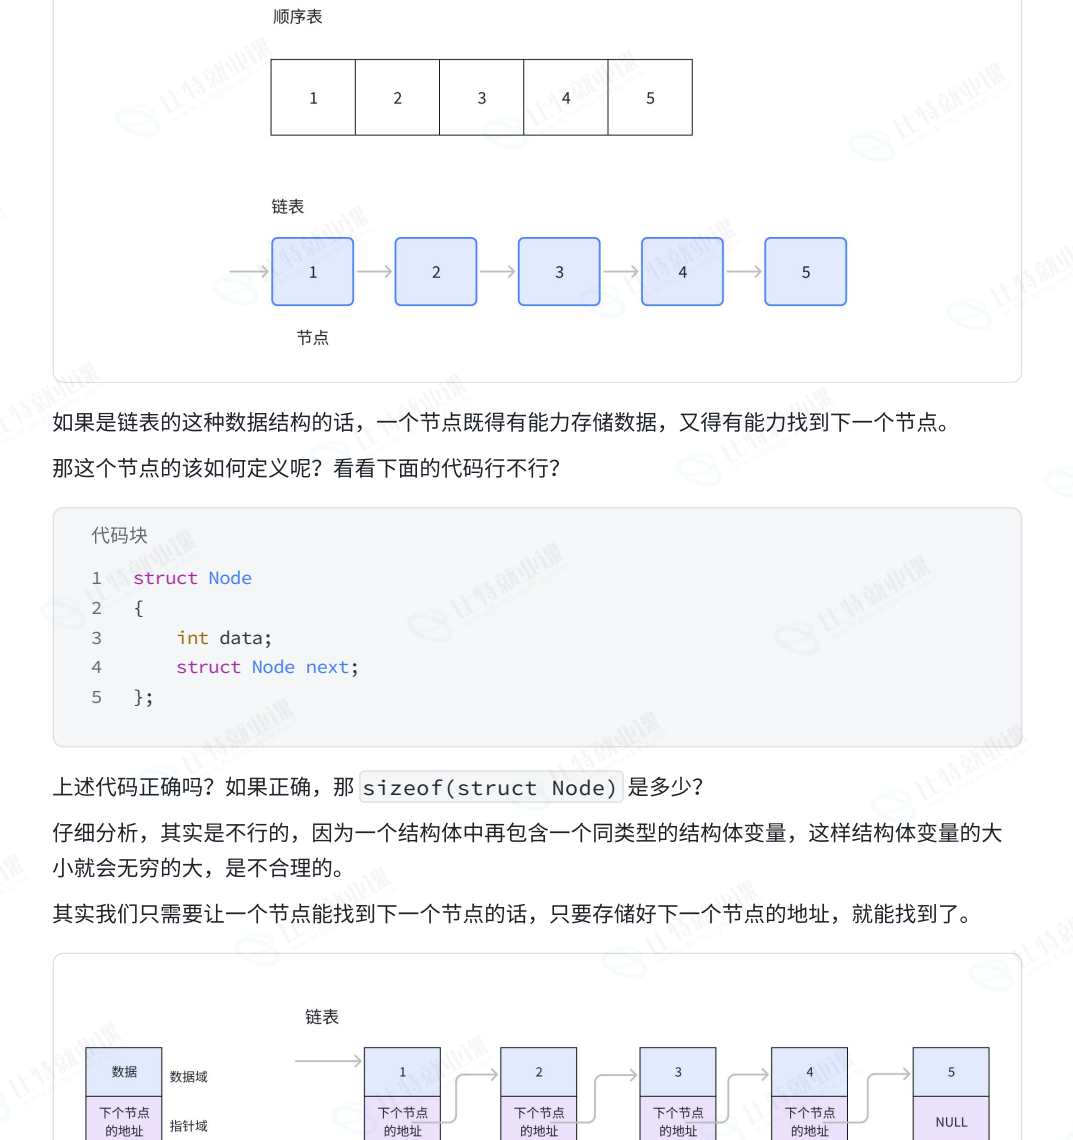
如果是链表的这种数据结构的话,一个节点既得有能力存储数据,又得有能力找到下一个节点。
那这个节点的该如何定义呢?看看下面的代码行不行?
课件代码 20-002 · PDF 第 3 页
struct Node{ int data; struct Node next;};上述代码正确吗?如果正确,那 sizeof(struct Node) 是多少?
仔细分析,其实是不行的,因为一个结构体中再包含一个同类型的结构体变量,这样结构体变量的大小就会无穷的大,是不合理的。
其实我们只需要让一个节点能找到下一个节点的话,只要存储好下一个节点的地址,就能找到了。
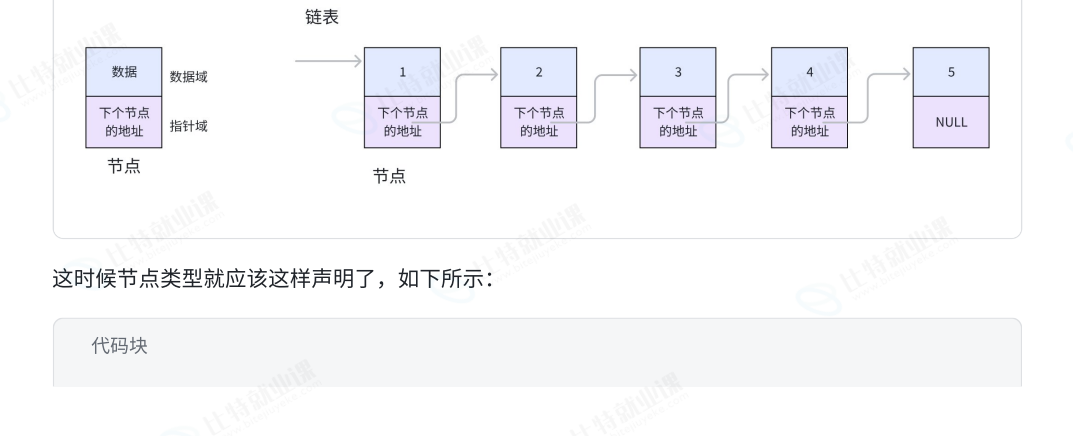
这时候节点类型就应该这样声明了,如下所示:
课件代码 20-003 · PDF 第 4 页
struct Node{ int data; struct Node* next;};这个就是结构体自引用的正确写法。
1.3 typedef简化结构体类型
我们在声明了结构体类型后,在使用的时候结构体类型书写的时候,不够简洁,比如:
课件代码 20-004 · PDF 第 4 页
struct Date{ int year; int month; int day;};
struct Student{ char name[20]; struct Date birthday; char id[20];};
struct Student s1;struct Student s2;struct Student 是结构体类型名,是否可以借助于 typedef 简化呢?是可以的。
课件代码 20-005 · PDF 第 4,5 页
struct Date{ int year; int month; int day;};
typedef struct Student{ char name[20]; struct Date birthday; char id[20];}Student;
Student s1;Student s2;这里的写法和,上一段代码的效果一模一样。
包含了结构体自引用的结构体类型,也可以使用typedef重命名的。
课件代码 20-006 · PDF 第 5 页
typedef struct Node{ int data; struct Node* next;}Node;
Node n1 = {0};1.4 匿名结构体类型
在声明结构的时候,可以不完全的声明,也就是匿名结构体类型。
1.4.1 匿名结构体类型只能使用一次
代码1 代码2
课件代码 20-007 · PDF 第 5 页
struct X{ int a; char b; float c;};struct X x;课件代码 20-008 · PDF 第 5 页
struct{ int a; char b; float c;}x;上面的代码2中,结构体类型中把结构体标签(X)省略不写,这个结构体类型就没有名字了,就是匿名结构体类型了。虽然是匿名结构类型,代码2中,顺便直接使用匿名类型创建了变量x,注意匿名结构体类型只能使用这一次,以后不能再用来创建变量了。
📌 虽然支持匿名结构体类型,但是不鼓励这么写,还是建议大家正常创建结构体类型。
1.4.2 成员相同也是不同的类型
课件代码 20-009 · PDF 第 6 页
//匿名结构体类型struct{ int a; char b; float c;}x;
struct{ int a; char b; float c;}a[20], *p = &x;上面代码中将&x赋值给p正确吗?答案是不正确。
📌 即使上面两个匿名结构体类型中成员一模一样,但是编译器会把它们当成完全不同的两个类
型,所以赋值是非法的,编译器也会给出警告的。
匿名的结构体类型,如果没有对结构体类型重命名的话,基本上只能使用一次。
课件代码 20-010 · PDF 第 6 页
//使用typedef对匿名结构体类型重命名typedef struct{ int a; char b; float c;} X; //X是新的类型名
X x1; //创建全局变量x1int main(){ X x2; //创建局部变量x2 return 0;}1.4.3 匿名结构体成员
案例1:
代码块 代码块
课件代码 20-011 · PDF 第 7 页
struct S{ int a; char b; struct //匿名结构-不创建变量 { float c; int d; };};课件代码 20-012 · PDF 第 7 页
int main(){ struct S s; s.a = 10; s.c = 3.5f; s.d = 100;
return 0;}struct S结构体类型 中包含了匿名结构体类型,但是又没有创建结构体变量,那么匿名结构的成员就是 struct S 结构体类型的成员。类似于:
课件代码 20-013 · PDF 第 7 页
struct S{ int a; char b; float c; int d;};案例2:
代码块 代码块
课件代码 20-014 · PDF 第 7 页
struct S{ int a; char b; struct //匿名结构-创建变量x { float c; int d; }x;};课件代码 20-015 · PDF 第 7 页
int main(){ struct S s; s.a = 10; s.x.c = 3.5f; s.x.d = 100;
return 0;}2. 结构体数组
整型数组中可以存放多个整型数据,字符数组中可以存放多个字符。
一个学生信息用一个结构体变量来存储,当我们有多个学生的信息的时候,是不是也可以有结构体数组呢?
答案是肯定的,结构体数组就是存放结构体数据的数组。
课件代码 20-016 · PDF 第 8 页
struct Date{ int year; int month; int day;};
//描述学生信息typedef struct Student{ char name[20]; struct Date birthday; char id[20];}Student;
int main(){ Student stu_arr[3] = { {"zhangsan", {2008,8,8}, "2026010101"}, {"lisi", {2009, 1, 10}, "2026010102"}, {"wangwu", {2009, 3, 20}, "2026010103"} }; int i = 0; for (i = 0; i < 3; i++) { printf("name:%s\tbirth:%d-%d-%d\tid:%s\n", stu_arr[i].name, stu_arr[i].birthday.year, stu_arr[i].birthday.month, stu_arr[i].birthday.day, stu_arr[i].id); }
return 0;}3. 结构体内存对齐
我们已经掌握了结构体的基本使用了。
现在我们深入讨论一个问题:计算结构体的大小。
这也是一个特别热门的考点: 结构体内存对齐先看一个代码:
课件代码 20-017 · PDF 第 9 页
struct S1{ char c1; char c2; int i;};
struct S2{ char c1; int i; char c2;};
int main(){ struct S1 s1 = {0}; struct S2 s2 = {0}; printf("%zu\n", sizeof(struct S1)); printf("%zu\n", sizeof(struct S2));
return 0;}输出的结果是:
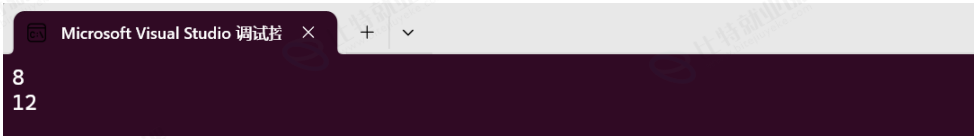
为什么呢?如果只看struct S1、struct S2结构体类型的成员的话,只要有6个字节,它们的成员都能进行存储的,但是实际运行输出的结构,却不是6,为什么呢?这就是结构体内存对齐导致的。
📌 结构体内存对齐是C/C++等语言中的一种内存布局规则。
编译器为了提升CPU访问内存的效率,会按照特定方式在结构体成员之间插入“填充字节”(padding),使得每个成员的起始地址都位于其“对齐边界”上。
3.1 对齐规则
-
结构体的第1个成员对齐到结构体变量的起始位置的0偏移处(也就是结构体变量的起始位置)。
-
从第2个成员变量开始,每个成员都对齐到对齐数的整数倍的偏移处。
对齐数 = 编译器默认对齐数 与 该成员变量大小的较小值。
- VS中默认的值为 8- Linux环境中 gcc 没有默认对齐数,对齐数就是成员自身的大小
- 结构体总大小为最大对齐数(结构体中每个成员变量都有一个对齐数,所有对齐数中最大的)的整
数倍。
- 如果嵌套了结构体的情况,嵌套的结构体成员对齐到自己的成员中最大对齐数的整数倍的偏移处,
结构体的整体大小就是所有最大对齐数(含嵌套结构体中成员的对齐数)的整数倍。
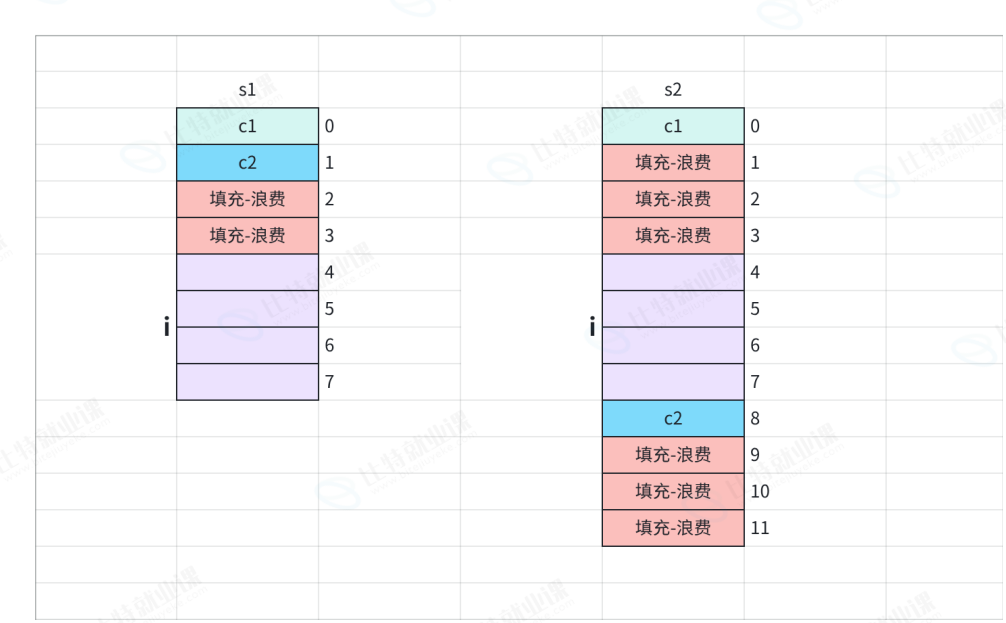
这时候我们再分析,上面的s1和s2在内存中的布局,应该就是这样的:
课件代码 20-018 · PDF 第 10,11 页
struct S3{ double d; char c; int i;};
//结构体嵌套问题struct S4{ char c1; struct S3 s3; double d;};
int main(){ struct S3 s3 = {0}; struct S4 s4 = {0}; printf("%zu\n", sizeof(struct S3)); printf("%zu\n", sizeof(struct S4));
return 0;}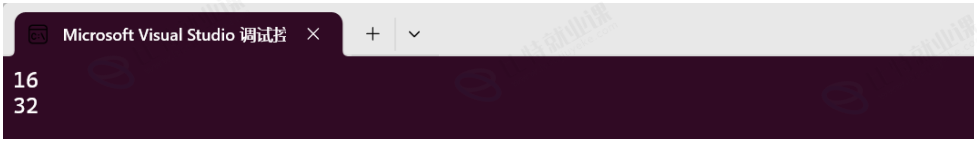
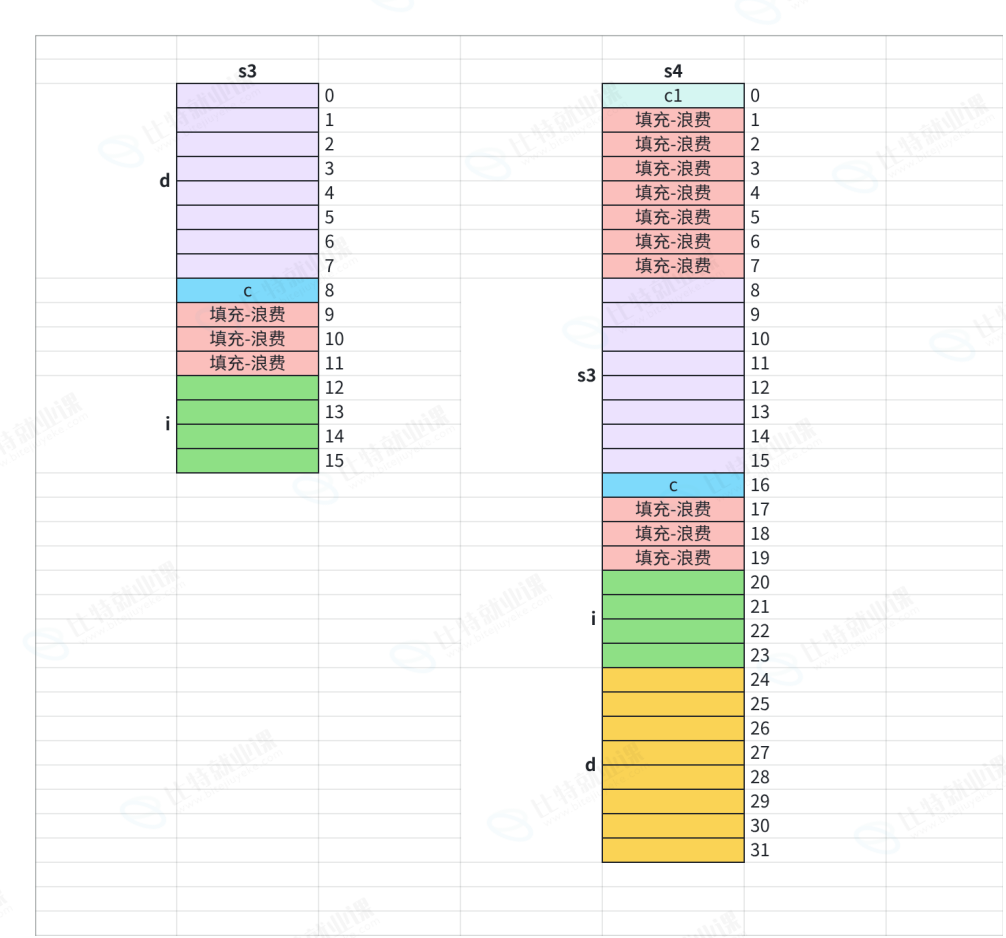
s3和s4内存布局如下:
3.2 为什么存在内存对齐?
1. 平台原因 (移植原因):
不是所有的硬件平台都能访问任意地址上的任意数据的;某些硬件平台只能在某些地址处取某些特定类型的数据,否则抛出硬件异常。
2. 性能原因:
现代 CPU 不是逐字节读写内存的,而是按对齐块(通常是 4 字节或 8 字节,取决于数据总线宽度和缓存行)批量读取。
假设 CPU 一次读取 4 字节,且只能从 4 的倍数地址开始读:
- 对齐的情况
一个 4 字节数据正好落在一次读取的范围内,CPU 只需一次内存访问就能完成。
- 非对齐的情况
如果这个 4 字节数据跨了两个对齐块的边界,CPU 就不得不做:
a. 读取第一个 4 字节块,截取后半部分;b. 读取第二个 4 字节块,截取前半部分;c. 将两部分拼在一起。
- 原本一次操作变成了两次内存访问 + 额外拼接操作,性能明显下降。
对于高频访问的结构体(如网络包、图形顶点等),这种开销是无法接受的。结构体内存对齐,就是用少量填充的代价,换取更少的 CPU 内存访问次数。总体来说:结构体的内存对齐是拿空间来换取时间的做法。
3.3 结构体设计的技巧
那在设计结构体的时候,既要满足对齐,又想节省空间,有什么技巧呢?
📌 让占用空间小的成员尽量集中在一起
我们前面使用的 struct S1 和 struct S2 两个类型,成员一模一样,只是顺序的差异,所占内存的大小却有差异。这说明结构体成员的顺序会影响到内存对齐。而将占用空间小的成员尽量集中在一起,可以更好的利用空间。
课件代码 20-019 · PDF 第 13 页
struct S1{ char c1; int i; char c2;};
struct S2{ char c1; char c2; int i;};3.4 修改默认对齐数
在VS2026的环境中,是存在默认对齐数的,那如果默认对齐数不合理,怎么办?
#pragma 这个预处理指令,可以改变编译器的默认对齐数,一般会设置为2的次方数,比如:1、2、4、8等。
课件代码 20-020 · PDF 第 14 页
#include <stdio.h>
#pragma pack(1)//设置默认对齐数为1struct S{ char c1; int i; char c2;};#pragma pack()//取消设置的对齐数,还原为默认
int main(){ //输出的结果是什么? printf("%d\n", sizeof(struct S)); return 0;}结构体在对齐方式不合适的时候,我们可以自己更改默认对齐数。
4. 结构的位段成员【加餐】
结构体讲完就得讲讲结构体中特殊的成员:位段或者叫位域。
4.1 什么是位段(位域)
结构体的成员在成员名的后面加上一个冒号和一个数字,就被称为位段成员。
C语言标准规定:位段的成员必须是 int、unsigned int 或signed int ,在C99中位段成员的类型也可以_Bool,但是现代编译器的实现中,位段的成员类型往往更加丰富,
- 编译器的实现可额外支持: char 、 short 、 long 、 long long 、枚举类型等,具体取决
于编译器。
位段举例:
课件代码 20-021 · PDF 第 14,15 页
struct A{ unsigned int a:2; unsigned int b:5; unsigned int c:10; unsigned int d:30;};A就是一个包含位段成员的结构体,那位段A所占内存的大小是多少?
课件代码 20-022 · PDF 第 15 页
printf("%zu\n", sizeof(struct A));4.2 位段的内存分配
-
位段成员可以是 int , unsigned int , signed int 或者是 char 等类型
-
位段的内存是按照成员的基础类型来按需申请内存空间的,如果成员是 unsigned int
, signed int 类型,一次按照4个字节来申请空间,如果成员是 signed char , unsigned char 类型,则一次按照1字节的大小来申请空间,按需扩展内存。
- 位段成员对内存的使用细节上有很多不确定的因素,都是取决于编译器实现的。
下面我们通过一个例子来分析一下:
课件代码 20-023 · PDF 第 15 页
#include <stdio.h>
struct S{ unsigned char a:3; unsigned char b:4; unsigned char c:5; unsigned char d:4;};
int main(){ struct S s = {0}; s.a = 10; s.b = 12; s.c = 3; s.d = 4; return 0;}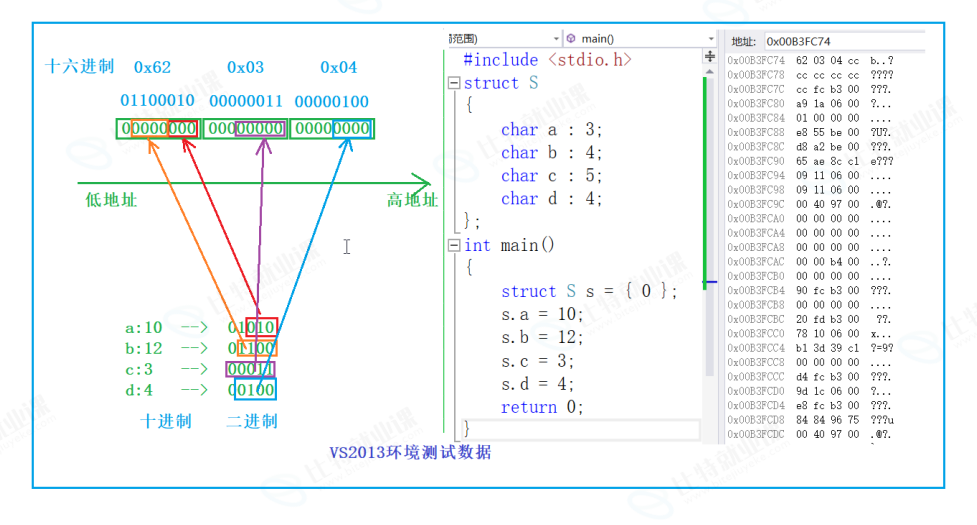
4.3 位段的跨平台问题
- int 位段被当成有符号数还是无符号数是不确定的,实践中都会写成 unsigned char 或者
unsigned int
- 位段中最大位的数目不能确定。(16位机器最大16,32位机器最大32,写成27,在16位机器会
出问题)
-
位段中的成员在内存中从左向右分配,还是从右向左分配,标准尚未定义。
-
当一个结构包含两个位段,第二个位段成员比较大,无法容纳于第一个位段剩余的位时,是舍弃
剩余的位还是利用,这是不确定的。
总结:
跟结构相比,位段如果可以达到同样的效果的情况下,可以很好的节省空间,这是优势。但是有跨平台的问题存在:位段涉及很多不确定因素,位段是不跨平台的,注重可移植的程序应该避免使用位段,或者针对性处理平台问题。
4.4 位段的应用
下图是网络协议中,IP数据报的格式,可见其中很多的属性只需要几个bit位就能描述,这里使用位段,能够实现想要的效果,也节省了空间,这样网络传输的数据报大小也会较小一些,对网络的畅通是有帮助的。
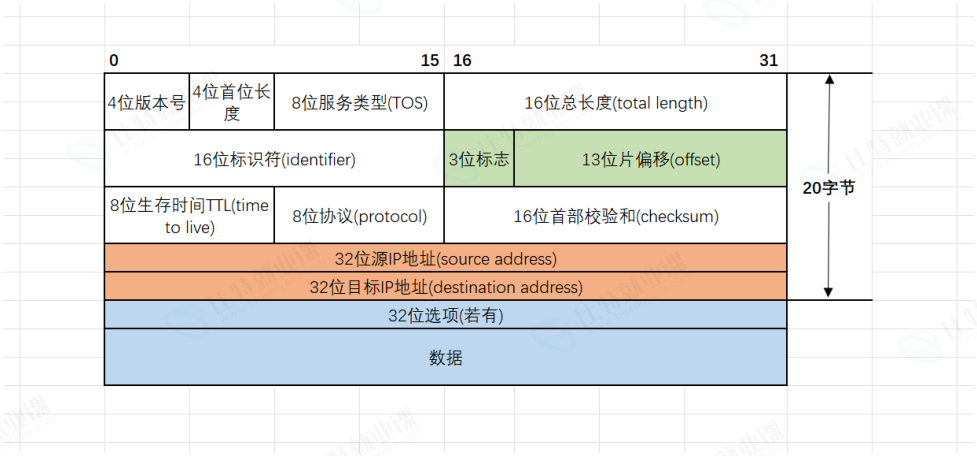
课件代码 20-024 · PDF 第 17 页
struct iphdr {#if defined(__LITTLE_ENDIAN_BITFIELD) __u8 ihl:4, // 首部长度(Internet Header Length) version:4; // 版本号(IPv4 = 4)#elif defined (__BIG_ENDIAN_BITFIELD) __u8 version:4, ihl:4;#else#error "Please fix <asm/byteorder.h>"#endif __u8 tos; // 服务类型 __be16 tot_len; // 总长度 __be16 id; // 标识 __be16 frag_off; // 分片偏移 __u8 ttl; // 生存时间 __u8 protocol; // 协议 __sum16 check; // 校验和 __be32 saddr; // 源地址 __be32 daddr; // 目的地址};参考代码:https://elixir.bootlin.com/linux/v6.10/source/include/uapi/linux/ip.h#L86
4.5 位段使用的注意事项
-
有的位段成员只占几个bit位,不够1个字节的长度,所以不能使用 sizeof 求位段成员的长度。
-
位段的几个成员共有同一个字节,这样有些成员的起始位置并不是某个字节的起始位置,那么这些
位置处是没有地址的。内存中每个字节分配一个地址,一个字节内部的bit位是没有地址的。所以不能对位段的成员使用&操作符,这样就不能使用scanf直接给位段的成员输入值,只能是先输入放在一个变量中,然后赋值给位段的成员。
课件代码 20-025 · PDF 第 18 页
struct A{ unsigned int _a : 2; unsigned int _b : 5; unsigned int _c : 10; unsigned int _d : 30;};
int main(){ struct A sa = {0}; scanf("%d", &sa._b);//这是错误的
//正确的示范 int b = 0; scanf("%d", &b); sa._b = b; return 0;}4.6 位段的特殊写法
- 无名位段(跳过某些位)
课件代码 20-026 · PDF 第 18 页
struct Example{ unsigned char a : 4; unsigned char : 4; // 跳过4位,不命名,无法访问 unsigned char b : 8;};- 零宽度位段(强制对齐到下一个存储单元)
课件代码 20-027 · PDF 第 18,19 页
struct Example2{ unsigned char a : 4; unsigned char : 0; // 强制后面的成员从新的“存储单元”开始 unsigned char b : 1; unsigned char c : 8;};AI编程实践1:使用结构体实现一个控制台上运行的通讯录程序
课件代码 20-028 · PDF 第 19 页
AI提示词:我想实现一个控制台上运行的通讯录程序,目前我学习了C语言的基础知识和结构体的知识,还没有学 习C语言动态内存管理,暂时实现成静态版本的,使用数组来存放数据;接下来我们使用SDD的方式来开 发这个程序,首先我们梳理一下需求,生成spec.md文件。AI编程实践2:改造通讯录为动态版本
课件代码 20-029 · PDF 第 19 页
AI提示词:现在我已经学习了C语言动态内存管理相关的知识,我希望使用柔性数组的方式,将程序中数据存储的 部分改造成动态增长的版本,如果空间不够的时候,可以扩容。本次开发,还是使用SDD的方式,我们先确认需求,然后结合 @spec.md 文件的内容进行更新。支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!