


C语言进阶 14:数组名、数组指针与二维数组传参
- 1C语言初阶 01:初识 C 语言与第一个程序
- 2C语言初阶 02:数据类型、变量、常量与字符
- 3C语言初阶 03:常见操作符与表达式求值
- 4C语言初阶 04:分支、循环与流程控制
- 5C语言初阶 05:用猜数字游戏串起分支与循环
- 6C语言初阶 06:一维数组、二维数组与字符串
- 7C语言初阶 07:函数设计、传参与多文件程序
- 8C语言初阶 08:从零组织命令行扫雷项目
- 9C语言初阶 09:用调试器定位错误与观察内存
- 10C语言初阶 10:函数递归、调用展开与递归的代价
- 11C语言初阶 11:地址、指针类型与指针运算
- 12C语言初阶 12:用结构体描述复杂对象
- 13C语言进阶 13:进制、补码、字节序与位运算
- 14C语言进阶 14:数组名、数组指针与二维数组传参本文
- 15C语言进阶 15:动态内存、realloc 与柔性数组
- 16C语言进阶 16:函数指针、回调与通用排序
- 17C语言进阶 17:指针的边界、const、断言与所有权
- 18C语言进阶 18:字符与字符串函数的完整使用规则
- 19C语言进阶 19:memcpy、memmove、memset 与 memcmp
- 20C语言进阶 20:结构体嵌套、自引用、对齐与位域
- 21C语言进阶 21:联合体、枚举与带标签的数据模型
- 22C语言进阶 22:从源代码到可执行文件的编译链接过程
- 23C语言进阶 23:宏、条件编译与预处理陷阱
- 24C语言进阶 24:文件读写、错误处理与数据持久化
代码块包含可运行实现、局部片段、输出、故意出错的示例与思考题;它们是独立示例,请结合上下文阅读,不能将整章拼成一个程序。
阅读前先核对
- 相同字符串字面量是否共享地址由实现决定,不能保证两个指针必定相等;比较内容用 strcmp。
- 数组表达式转换有 sizeof、一元 & 等例外;二维数组转换为行指针,不能当作 int **。强制转换不能修复错误的行宽或越界。
本章目标
-
数组名的深刻理解和在代码中的使用
-
掌握一维数组传参的本质
-
掌握冒泡排序和优化
-
掌握数组指针变量和二维数组传参的本质
-
掌握指针数组
-
能够使用指针数组模拟二维数组
1. 数组名的理解
1.1 认识数组名
在指针初阶部分,我们在使用指针访问数组的内容时,有这样的代码:
课件代码 14-001 · PDF 第 1 页
int arr[10] = {1,2,3,4,5,6,7,8,9,10};int *p = &arr[0];这里我们使用 &arr[0] 的方式拿到了数组第一个元素的地址,但是其实数组名也是地址,是数组首元素的地址,我们来做个测试。
课件代码 14-002 · PDF 第 1 页
#include <stdio.h>int main(){ int arr[10] = { 1,2,3,4,5,6,7,8,9,10 }; printf("&arr[0] = %p\n", &arr[0]); printf("arr = %p\n", arr); return 0;}输出结果:
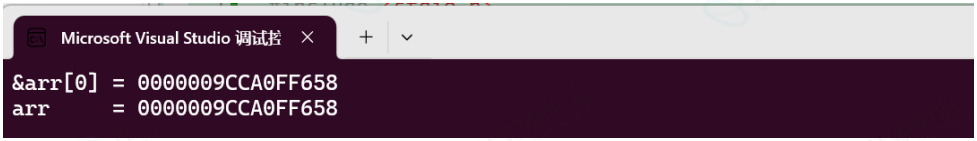
我们发现数组名和数组首元素的地址打印出的结果一模一样,数组名就是数组首元素(第一个元素)的地址。
这时候有同学会有疑问?数组名如果是数组首元素的地址,那下面的代码怎么理解呢?
课件代码 14-003 · PDF 第 2 页
#include <stdio.h>int main(){ int arr[10] = { 1,2,3,4,5,6,7,8,9,10 }; printf("%d\n", sizeof(arr)); return 0;}输出的结果是:40,如果 arr 是数组首元素的地址,那输出应该的应该是 4 或者 8 才对呀。
其实数组名就是数组首元素(第一个元素)的地址是对的,但是有两个例外:
- sizeof(数组名),sizeof中单独放数组名,这里的数组名表示整个数组,计算的是整个数组的大小,
单位是字节
- &数组名,这里的数组名表示整个数组,取出的是整个数组的地址(整个数组的地址和数组首元素
的地址虽然值是一样的,但是类型不同)除去这两种场景之外,任何地方使用数组名,数组名都表示首元素的地址。
这时有好奇的同学,再试一下这个代码:
课件代码 14-004 · PDF 第 2,3 页
#include <stdio.h>int main(){ int arr[10] = { 1,2,3,4,5,6,7,8,9,10 }; printf("&arr[0] = %p\n", &arr[0]); printf("arr = %p\n", arr); printf("&arr = %p\n", &arr); return 0;}测试输出的结果:
课件代码 14-005 · PDF 第 3 页
&arr[0] = 000000EEAA0FF8E8arr = 000000EEAA0FF8E8&arr = 000000EEAA0FF8E8三个打印结果一模一样,这时候又纳闷了,那arr和&arr有啥区别呢?
课件代码 14-006 · PDF 第 3 页
#include <stdio.h>int main(){ int arr[10] = { 1,2,3,4,5,6,7,8,9,10 }; printf("&arr[0] = %p\n", &arr[0]); printf("&arr[0]+1 = %p\n", &arr[0]+1); printf("arr = %p\n", arr); printf("arr+1 = %p\n", arr+1); printf("&arr = %p\n", &arr); printf("&arr+1 = %p\n", &arr+1); return 0;}输出结果:
课件代码 14-007 · PDF 第 3 页
&arr[0] = 0000000EE7CFF648 //int*&arr[0]+1 = 0000000EE7CFF64Carr = 0000000EE7CFF648 //int*arr+1 = 0000000EE7CFF64C&arr = 0000000EE7CFF648 //int(*)[10]&arr+1 = 0000000EE7CFF670这里我们发现 &arr[0] 和 &arr[0]+1 相差 4 个字节, arr 和 arr+1 相差4个字节,是因为&arr[0] 和 arr 都是首元素的地址, +1 就是跳过一个元素,也就是4个字节。
但是 &arr 和 &arr+1 相差40个字节,这就是因为 &arr 是数组的地址, +1 操作是跳过整个数组的。
到这里我们应该就分析清楚数组名在不同代码场景下的意思了。
🎈 • sizeof(数组名),这里的数组名表示整个数组,计算的是整个数组的大小,单位是字节
- &数组名,这里的数组名表示整个数组,取出的是整个数组的地址
除去这两种场景之外,任何地方使用数组名,数组名都表示首元素的地址当数组名表示数组首元素的地址时,地址是一个常量的值,是不能修改的,所以下面代码中的赋值就是非法的。
课件代码 14-008 · PDF 第 4 页
int arr1[5] = {1,2,3,4,5};int arr2[5] = {0};arr1 = arr2;//err1.2 重新认识指针访问数组
这里我们重新梳理一下之前学习过的使用指针访问一维数组的代码:
课件代码 14-009 · PDF 第 4 页
#include <stdio.h>int main(){ int arr[10] = {1,2,3,4,5,6,7,8,9,10}; int *p = &arr[0]; //获得第一个元素的地址 int i = 0; int sz = sizeof(arr)/sizeof(arr[0]); for(i = 0; i < sz; i++) { printf("%d ", *(p + i));//p+i是下标为i这个元素的地址 } return 0;}上面代码中第5行的代码,就可以换成:
课件代码 14-010 · PDF 第 4,5 页
#include <stdio.h>int main(){ int arr[10] = {1,2,3,4,5,6,7,8,9,10}; int *p = arr; //获得第一个元素的地址 int i = 0; int sz = sizeof(arr)/sizeof(arr[0]); for(i = 0; i < sz; i++) { printf("%d ", *(p + i));//p+i是下标为i这个元素的地址 } return 0;}那么我们再分析一下, arr 是首元素的地址,赋值给了 p , p 变量中存放的也是首元素的地址,这里的 arr 和 p 是等价的。那么我们可以把上面代码中第10行的 p 换成 arr ,代码如下:
课件代码 14-011 · PDF 第 5 页
#include <stdio.h>int main(){ int arr[10] = {1,2,3,4,5,6,7,8,9,10}; int *p = arr; //获得第一个元素的地址 int i = 0; int sz = sizeof(arr)/sizeof(arr[0]); for(i = 0; i < sz; i++) { printf("%d ", *(arr + i)); //arr+i是下标为i这个元素的地址 //*(arr + i) 就是下标i的元素,也就是arr[i] } return 0;}代码中的 *(arr + i) 就是下标 i 的元素,也就是 arr[i] 。
那么我们可以推出: *(p + i) 等价于 *(arr + i) 等价于 arr[i] 等价于 p[i]在访问一个数组元素的时候,数组下标的写法和指针的写法可以互相转换的。其实写成 arr[i] ,编译器也要转换成 *(arr+i) 的方式来处理的。那这两种写法哪种好点呢?
-
arr[i] 是语法糖,简洁直观,不容易出错
-
现代编译器对这两种写法生成的机器码完全相同,因此不需要为了“效率”而刻意写指针形式,除
非处于特殊的底层编程(如嵌入式、手写汇编)。
1.3 再谈字符指针
在指针的类型中有一种指针类型为字符指针 char* ;一般使用:
课件代码 14-012 · PDF 第 6 页
#include <stdio.h>int main(){ char ch = 'w'; char *pc = &ch; *pc = 'w'; return 0;}字符指针指向常量字符串:
课件代码 14-013 · PDF 第 6 页
#include <stdio.h>int main(){ const char* pstr = "hello bit";//这里是把一个字符串放到pstr指针变量里了吗? printf("%s\n", pstr); return 0;}我们可以通俗的理解为 pstr 指针变量,指向了一个常量字符串”hello bit”。
常量字符串和字符数组很相似,也可以按照下标来访问,但是常量字符串是只读的,也就是不能被修改。
数组可以放在内存的栈区、静态区,常量字符串是放在内存的只读数据区的,如果修改常量字符串程序会崩溃。
const 关键字会在《指针的最佳实践》部分讲解
课件代码 14-014 · PDF 第 6,7 页
#include <stdio.h>
int main(){ const char* pstr = "hello bit";//这里是把一个字符串放到pstr指针变量里了吗? printf("%c\n", pstr[1]); printf("%c\n", "hello bit"[1]); return 0;}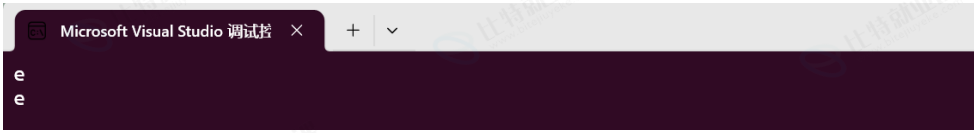
代码 const char* pstr = “hello bit”; 特别容易被理解为:是把字符串 hello bit 放到字符指针 pstr 里了,但是本质是把字符串 hello bit 首字符 ‘h’ 的地址放到了 pstr 中。
上面代码的意思是把一个常量字符串的首字符 h 的地址存放到指针变量 pstr 中。
《剑指offer》中收录了一道和字符数组和常量字符串相关的笔试题,我们一起来学习一下:
课件代码 14-015 · PDF 第 7,8 页
#include <stdio.h>
int main(){ char str1[] = "hello bit."; char str2[] = "hello bit."; const char *str3 = "hello bit."; const char *str4 = "hello bit.";
if(str1 ==str2) printf("str1 and str2 are same\n"); else printf("str1 and str2 are not same\n");
if(str3 ==str4) printf("str3 and str4 are same\n"); else printf("str3 and str4 are not same\n");
return 0;}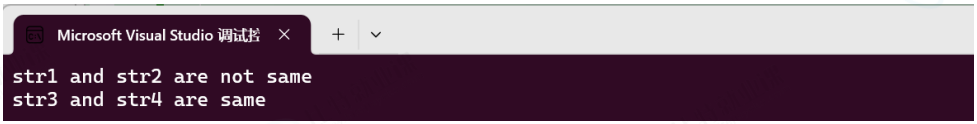
这里 str3 和 str4 指向的是一个同一个常量字符串。C/C++会把常量字符串存储到单独的一个内存区域,当几个指针指向同一个常量字符串的时候,他们实际会指向同一块内存。但是用相同的常量字符串去初始化不同的数组的时候就会开辟出不同的内存块。所以 str1 和 str2 不同, str3 和str4 相同。
1.4 练习
练习1:程序运行的结果是啥?
课件代码 14-016 · PDF 第 8 页
#include <stdio.h>
int main(){ int a[] = {1,2,3,4}; printf("%zu\n",sizeof(a)); printf("%zu\n",sizeof(a+0)); printf("%zu\n",sizeof(*a)); printf("%zu\n",sizeof(&a)); printf("%zu\n",sizeof(*&a)); printf("%zu\n",sizeof(&a[0]+1)); return 0;}练习2:程序运行的结果是啥?
课件代码 14-017 · PDF 第 9 页
#include <stdio.h>
int main(){ int a[5] = { 1, 2, 3, 4, 5 }; int *ptr = (int *)(&a + 1); printf( "%d,%d", *(a + 1), *(ptr - 1)); return 0;}2. 一维数组传参和指针
在学习数组的时候,可以把一维数组作为参数传递给函数,假设我们要写一个函数打印数组,代码如下:
课件代码 14-018 · PDF 第 9,10 页
#include <stdio.h>void Print(int arr[], int sz){ int i = 0; for (i = 0; i < sz; i++) { printf("%d ", arr[i]); } printf("\n");}
int main(){ int arr[10] = { 1,2,3,4,5,6,7,8,9,10 }; int sz = sizeof(arr) / sizeof(arr[0]); Print(arr, sz); return 0;}这里我们设计的 Print 函数的参数写成了数组的形式,数组传参,形参写成数组的形式,非常直观、容易理解。
但是当我们理解了数组名其实是数组首元素的地址时,我们继续往下想,上面的代码中第 16 行,调用 Print(arr, sz) 函数时传递的数组名 arr 就是数组首元素的地址,那形参应该写成指针类型也应该是正确的吧?对的,这就是一维数组传参的本质:传递的是首元素的地址。
所以代码也可以这么写:
课件代码 14-019 · PDF 第 10 页
#include <stdio.h>void Print(int *arr, int sz){ int i = 0; for (i = 0; i < sz; i++) { printf("%d ", *(arr+i)); } printf("\n");}
int main(){ int arr[10] = { 1,2,3,4,5,6,7,8,9,10 }; int sz = sizeof(arr) / sizeof(arr[0]); Print(arr, sz); return 0;}既然数组传参传递的是数组首元素的地址,那么形参的指针找到数组和实参的数组就是同一个数组了,这样我们就彻底理解了,为什么我们在学习函数章节的时候,说:一维数组传参的时候,形参不会创建新的数组,形参数组和实参数组是同一个数组了。
❓ 那函数传参的时候形参建议写数组的形式?还是指针的形式呢?
我的建议是写成数组的形式,代码可读性更好,更容易维护。
在现代的编译器上,其实写成指针的形式和数组的形式性能差异不大。
3. 冒泡排序
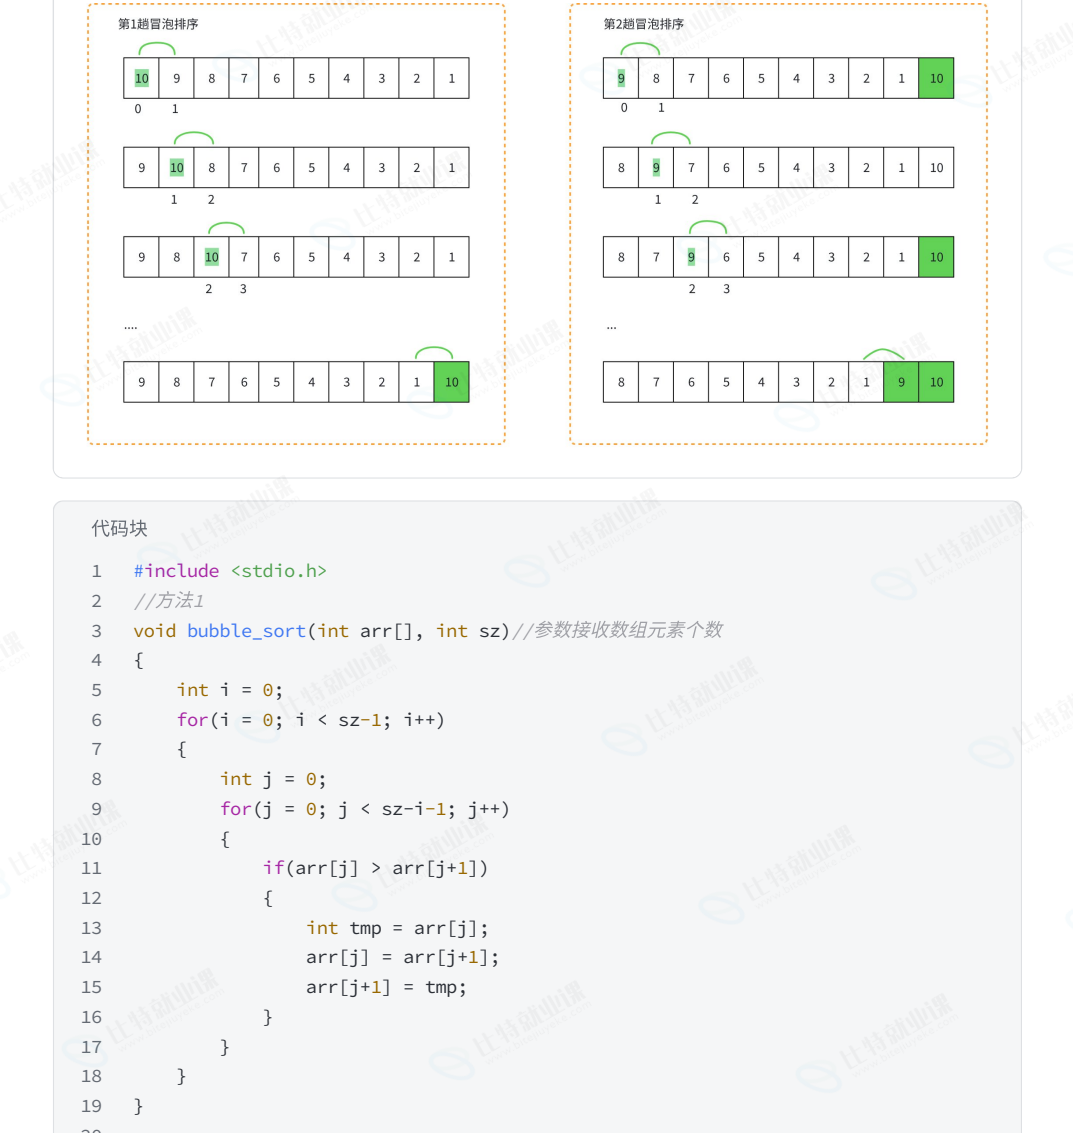
冒泡排序(Bubble Sort)是最基础的排序算法之一。它的核心思想很简单:重复遍历要排序的列表,依次比较相邻的两个元素,如果顺序错误就交换它们。每一轮遍历都会把当前未排序部分中最大(或最小)的元素“浮”到顶端,就像气泡一样上浮,因此得名。
现在有一组数据: 10 9 8 7 6 5 4 3 2 1 ,需要对数据进行排序,目标是升序
课件代码 14-020 · PDF 第 11,12 页
#include <stdio.h>//方法1void bubble_sort(int arr[], int sz)//参数接收数组元素个数{ int i = 0; for(i = 0; i < sz-1; i++) { int j = 0; for(j = 0; j < sz-i-1; j++) { if(arr[j] > arr[j+1]) { int tmp = arr[j]; arr[j] = arr[j+1]; arr[j+1] = tmp; } } }}int main(){ int arr[] = {10,9,8,7,6,5,4,3,2,1}; //{3,1,7,5,8,9,0,2,4,6}; int sz = sizeof(arr)/sizeof(arr[0]); bubble_sort(arr, sz); int i = 0; for(i = 0; i < sz; i++) { printf("%d ", arr[i]); } return 0;}我们写的这个冒泡排序2层for循环,循环次数是按照元素个数推算出来的。
但是如果待排序的数据是这样的:
课件代码 14-021 · PDF 第 12 页
9 8 7 6 10 5 4 3 2 1经过第1趟排序后:9 8 7 6 5 4 3 2 1 10 //此时已经有序了,但是程序不知道进行第2趟排序时:相邻的元素都不会发生交换,就说明已经有序了,就没必要继续循环处理了所以上面的代码是有优化空间的,尤其是在数据接近有序的情况下,优化代码如下:
课件代码 14-022 · PDF 第 12,13 页
#include <stdio.h>void bubble_sort(int arr[], int sz)//参数接收数组元素个数{ int i = 0; for(i = 0; i < sz-1; i++) { int flag = 1;//假设这一趟已经有序了 int j = 0; for(j = 0; j < sz-i-1; j++) { if(arr[j] > arr[j+1]) { flag = 0;//发生交换就说明,无序 int tmp = arr[j]; arr[j] = arr[j+1]; arr[j+1] = tmp; } } if(flag == 1)//这一趟没交换就说明已经有序,后续无序排序了 break; }}
int main(){ int arr[] = {9,8,7,6,10,5,4,3,2,1}; int sz = sizeof(arr)/sizeof(arr[0]); bubble_sort(arr, sz); int i = 0; for(i = 0; i < sz; i++) { printf("%d ", arr[i]); } return 0;}4. 数组指针变量
4.1 数组指针变量是什么?
数组指针变量是指针变量?还是数组?
答案是:指针变量。
我们已经熟悉:
-
整形指针变量: int* pint; 存放的是整形变量的地址,能够指向整形数据的指针。
-
浮点型指针变量: float* pf; 存放浮点型变量的地址,能够指向浮点型数据的指针。
那数组指针变量应该是:存放的应该是数组的地址,能够指向数组的指针变量。
举例如下:
课件代码 14-023 · PDF 第 13 页
int (*p)[10];解释: p 先和 * 相遇,说明 p 是一个指针变量,然后指针指向的是一个大小为10个元素的数组,数组的每个元素是int类型,所以 p 是一个指针,指向一个数组,叫 数组指针变量。
这里要注意: [] 的优先级要高于 * 号的,所以必须加上 () 来保证 p 先和 * 结合。
4.2 数组指针变量初始化
数组指针变量是用来存放数组地址的,那怎么获得数组的地址呢?就是我们之前学习的 &数组名 。
课件代码 14-024 · PDF 第 14 页
int arr[10] = {0};&arr;//得到的就是数组的地址如果要存放个数组的地址,就得存放在数组指针变量中,如下:
课件代码 14-025 · PDF 第 14 页
int(*p)[10] = &arr;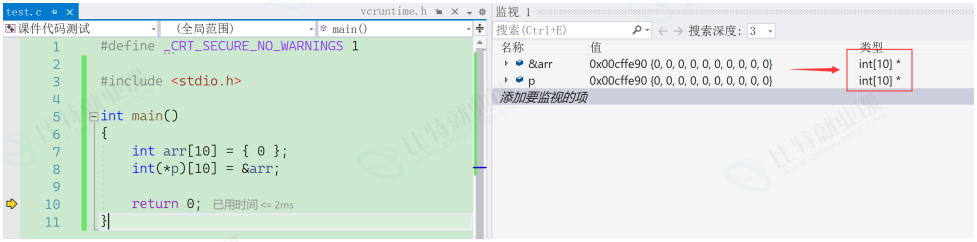
我们调试也能看到 &arr 和 p 的类型是完全一致的。
数组指针类型解析:
课件代码 14-026 · PDF 第 14 页
int (* p) [10] = &arr; | | | | | | | | p指向数组的元素个数 | p是数组指针变量名 p指向的数组的元素类型5. 二维数组传参和指针
有了数组指针的理解,我们就能够讲一下二维数组传参和指针的关系。
过去二维数组需要传参给一个函数的时候时,我们是这样写的:
课件代码 14-027 · PDF 第 14,15 页
#include <stdio.h>
void test(int a[3][5], int r, int c){ int i = 0; int j = 0; for(i = 0; i < r; i++) { for(j = 0; j < c; j++) { printf("%d ", a[i][j]); } printf("\n"); }}
int main(){ int arr[3][5] = {{1,2,3,4,5}, {2,3,4,5,6},{3,4,5,6,7}}; test(arr, 3, 5); return 0;}这里实参是二维数组,形参也写成二维数组的形式,那还有什么其他的写法吗?毕竟二维数组传参,实参也写的是数组名,数组名是数组首元素的地址呀。那形参能写成指针吗?
首先我们再次理解一下二维数组,二维数组其实可以看做是每个元素是一维数组的数组,也就是二维数组的每个元素是一个一维数组。那么二维数组的首元素就是第一行,是个一维数组。
如下图:
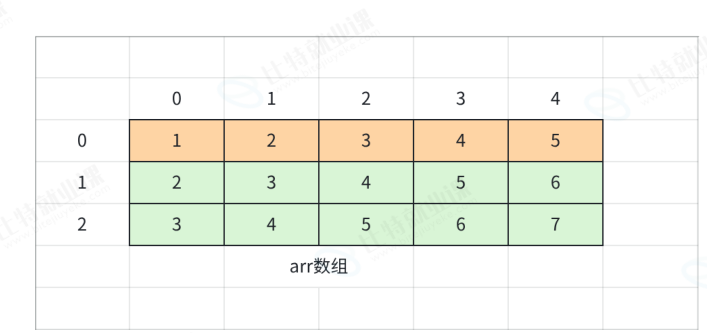
所以,根据数组名是数组首元素的地址这个规则,二维数组的数组名表示的就是第一行的地址,是一维数组的地址。根据上面的例子,第一行的一维数组的类型就是 int [5] ,所以第一行的地址的类型就是数组指针类型 int(*)[5] 。那就意味着二维数组传参本质上也是传递了地址,传递的是第一行这个一维数组的地址,那么形参也是可以写成指针形式的。如下:
课件代码 14-028 · PDF 第 16 页
#include <stdio.h>
void test(int (*p)[5], int r, int c){ int i = 0; int j = 0; for(i = 0; i < r; i++) { for(j = 0; j < c; j++) { printf("%d ", *(*(p+i)+j)); //p+i 是第i行的地址 //*(p+i) == p[i], 是第i行的数组名 //数组名是首元素的地址,所以*(p+i) 也是第i行第一个元素的地址 //*(p+i)+j 就是第i行,下标为j的元素的地址 //*(*(p+i)+j))就是i行,j列的元素 //*(*(p+i)+j)) == p[i][j] } printf("\n"); }}
int main(){ int arr[3][5] = {{1,2,3,4,5}, {2,3,4,5,6},{3,4,5,6,7}}; test(arr, 3, 5); return 0;}总结:二维数组传参,形参的部分可以写成二维数组,也可以写成数组指针的形式。
练习:
课件代码 14-029 · PDF 第 16 页
#include <stdio.h>int main(){ int aa[2][5] = { 1, 2, 3, 4, 5, 6, 7, 8, 9, 10 }; int *ptr1 = (int *)(&aa + 1); int *ptr2 = (int *)(*(aa + 1)); printf( "%d,%d", *(ptr1 - 1), *(ptr2 - 1)); return 0;}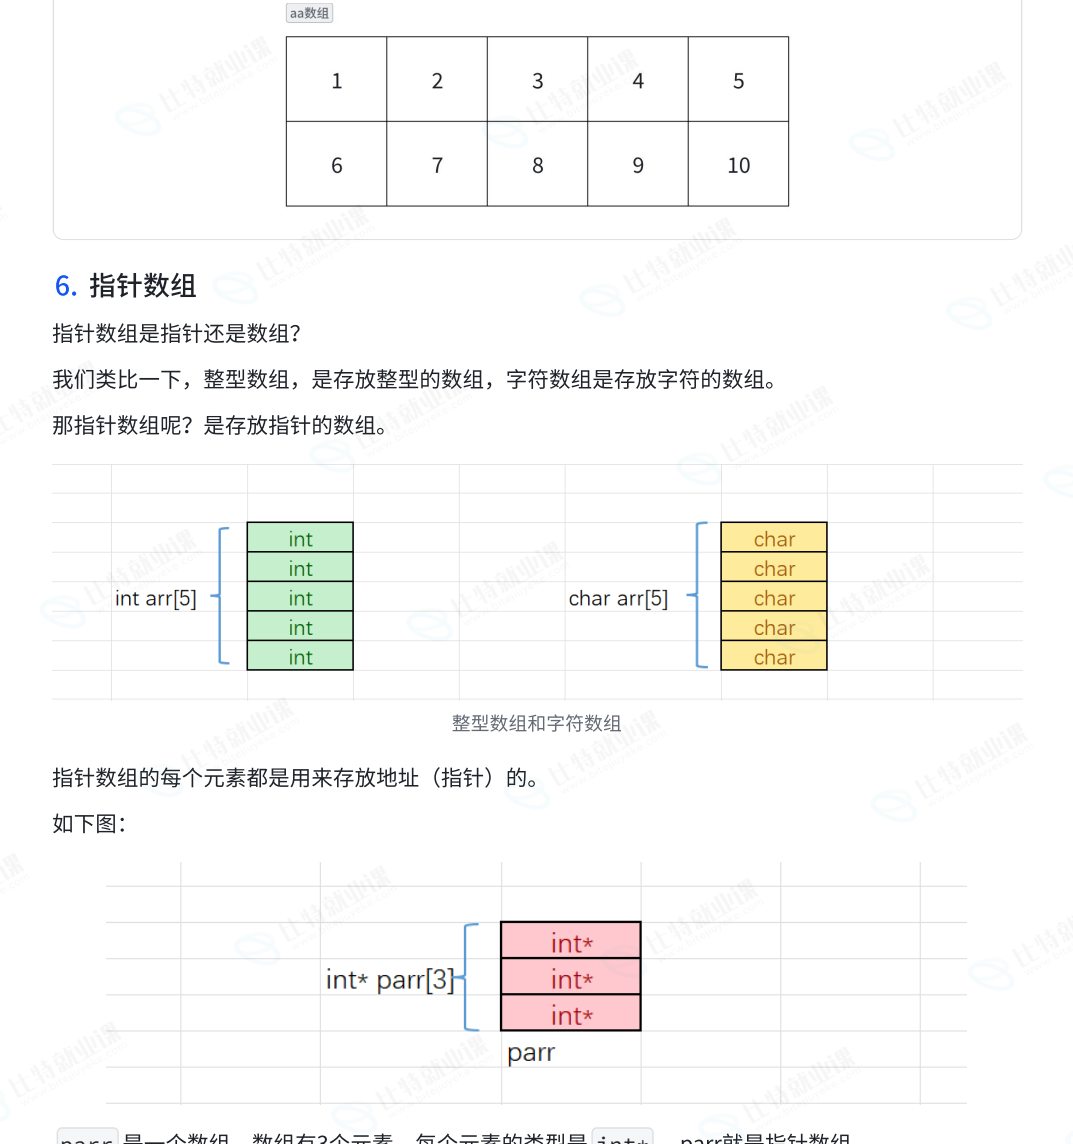
6. 指针数组
指针数组是指针还是数组?
我们类比一下,整型数组,是存放整型的数组,字符数组是存放字符的数组。
那指针数组呢?是存放指针的数组。
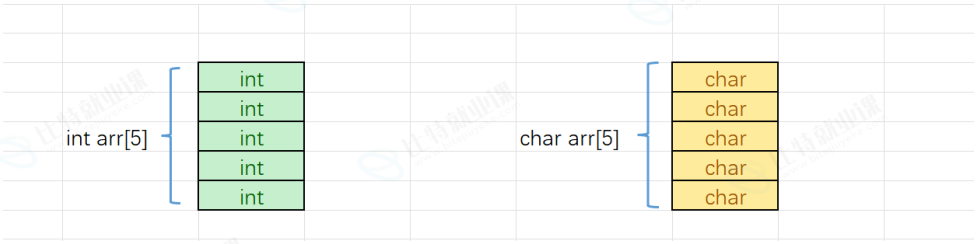
整型数组和字符数组指针数组的每个元素都是用来存放地址(指针)的。
如下图:
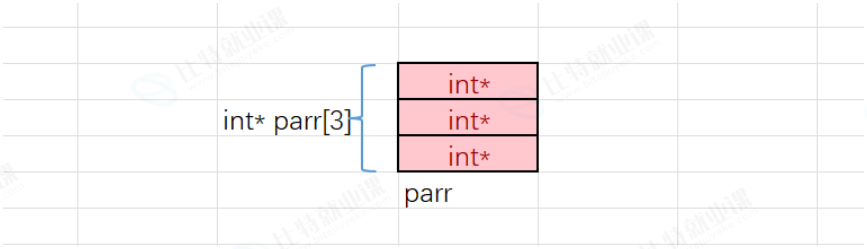
parr 是一个数组,数组有3个元素,每个元素的类型是 int* ,parr就是指针数组。
指针数组的每个元素是地址,又可以指向一块区域。
7. 指针数组模拟二维数组
课件代码 14-030 · PDF 第 18 页
#include <stdio.h>int main(){ int arr1[] = {1,2,3,4,5}; int arr2[] = {2,3,4,5,6}; int arr3[] = {3,4,5,6,7}; //数组名是数组首元素的地址,类型是int*的,就可以存放在parr数组中 int* parr[3] = {arr1, arr2, arr3}; int i = 0; int j = 0; for(i = 0; i < 3; i++) { for(j = 0; j < 5; j++) { printf("%d ", parr[i][j]); } printf("\n"); } return 0;}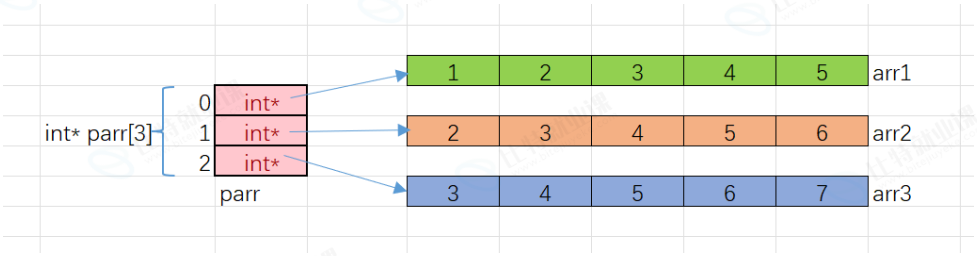
parr数组的画图演示parr[i] 是访问 parr 数组的元素, parr[i] 找到的数组元素指向了整型一维数组, parr[i][j] 就是整型一维数组中的元素。
上述的代码模拟出二维数组的效果,实际上并非完全是二维数组,因为每一行并非是连续的。
练习1:下面代码输出的结果是啥?
课件代码 14-031 · PDF 第 18,19 页
#include <stdio.h>int main(){ char *a[] = {"work","at","alibaba"}; char**pa = a; pa++; printf("%s\n", *pa); return 0;}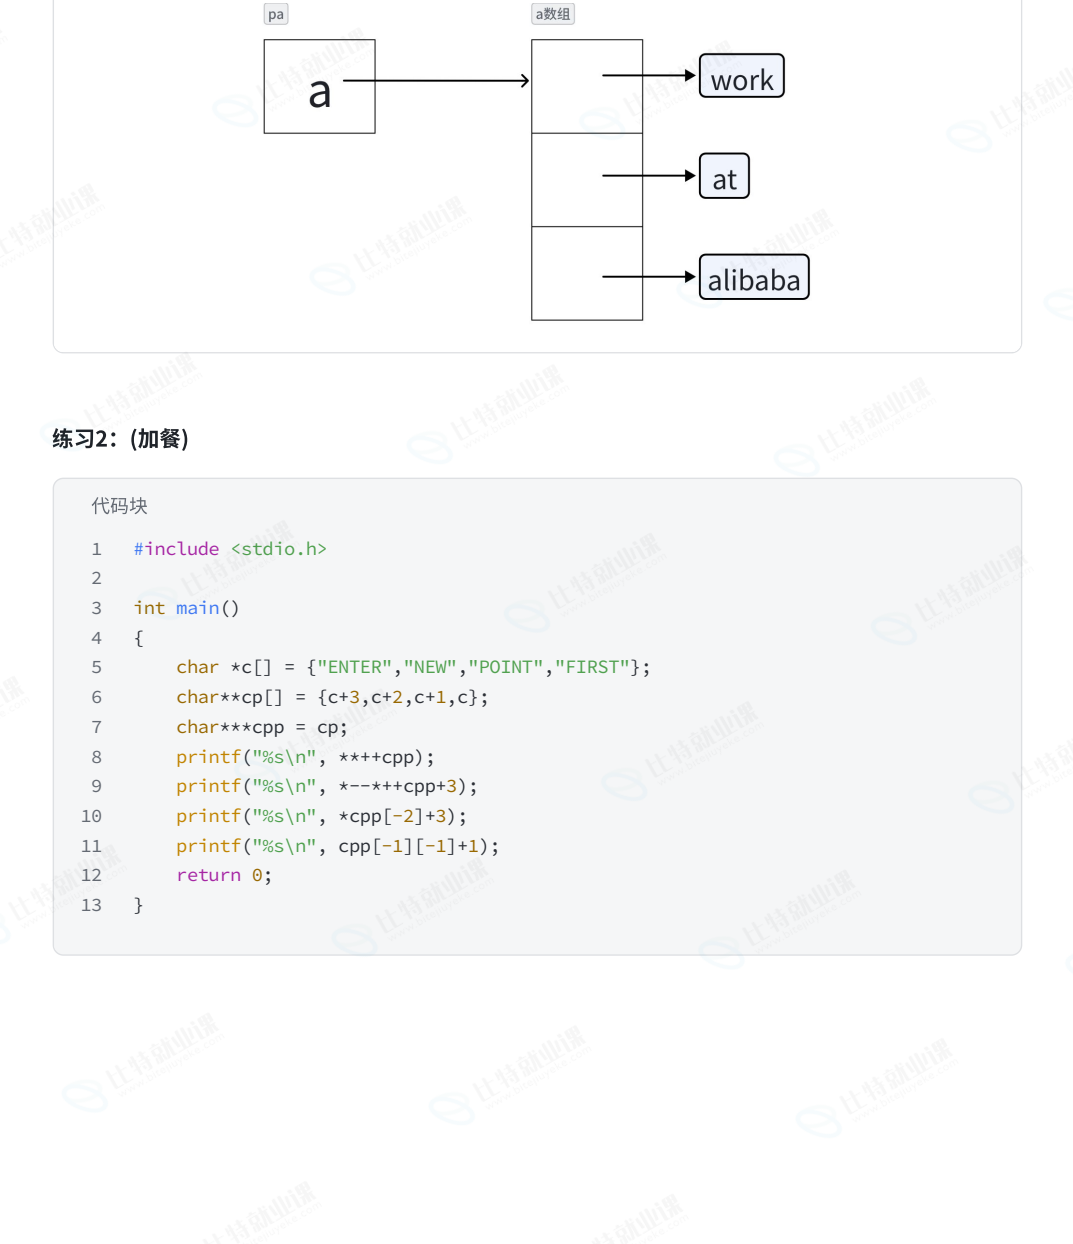
练习2:(加餐)
课件代码 14-032 · PDF 第 19 页
#include <stdio.h>
int main(){ char *c[] = {"ENTER","NEW","POINT","FIRST"}; char**cp[] = {c+3,c+2,c+1,c}; char***cpp = cp; printf("%s\n", **++cpp); printf("%s\n", *--*++cpp+3); printf("%s\n", *cpp[-2]+3); printf("%s\n", cpp[-1][-1]+1); return 0;}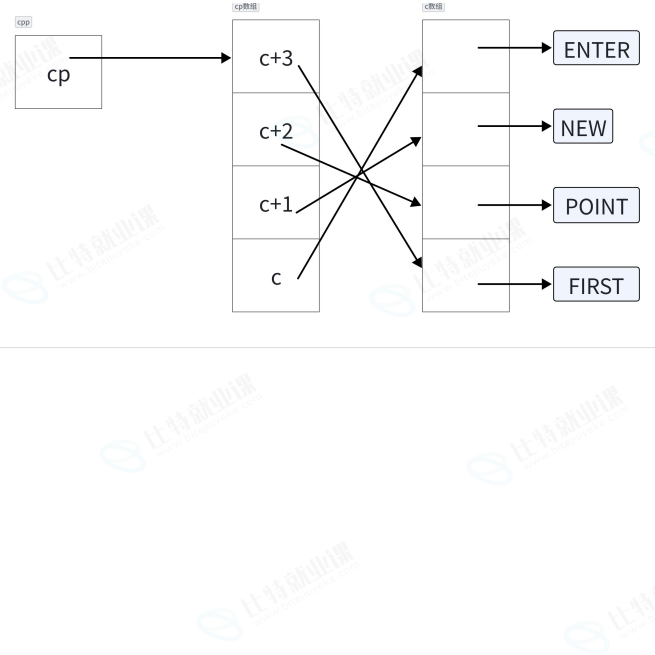
支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!